中文名称:电子与信息学报杂志
刊物语言:中文
刊物规格:A4
主管单位:中国科学院
主办单位:中国科学院
创刊时间:1979
出版周期:月刊
国内刊号:11-4494/TN
国际刊号:1009-5896
邮发代号:2-179
刊物定价:1272.00元/年
出版地:北京
个 DeepSeek 保姆级高级指令,把论文 AIGC 检出率从 90% 压至 0
时间:2026-10-16 10:39:06
不少写作者都遇见过这种糟心状况:熬了好几天把论文写完,找DeepSeek把全文润色了一遍,本来觉得行文顺、逻辑也顺,挺满意的拿去做AIGC检测,结果报告一出来,AI生成占比直接冲到80%以上。
明明核心思路、内容框架全是自己想出来的,怎么通篇都飘着一股化不开的“AI味儿”?看着检测页面上一大片一大片亮起来的疑似AI标记,铺得满屏都是,熬了无数心血攒出来的稿子瞬间就被动了,这种说不出的憋屈感,怕是好多创作者都深有体会。
出现这种情况,根本不是你写作水平不行。各类AIGC检测工具,盯的就是AI生成文本独有的共性特征:比如一层套一层的超长复杂句、堆得密密麻麻的书面套话、看起来逻辑严丝合缝实则空得没内容的排比句,全是检测模型重点抓的目标。说白了,AI写稿最喜欢用的那套固定表达范式,刚好就是检测系统重点盯的识别靶心。
真想把AIGC检出率压下来,别信什么“点一下就消掉所有AI痕迹”的玄学操作。要从根上弱化机器生成的文本特质,就得摸透反向调整的实操逻辑,核心目标只有一个:让文字彻底回归普通人的写作习惯,把机器文本千篇一律的标准化质感全给褪掉。
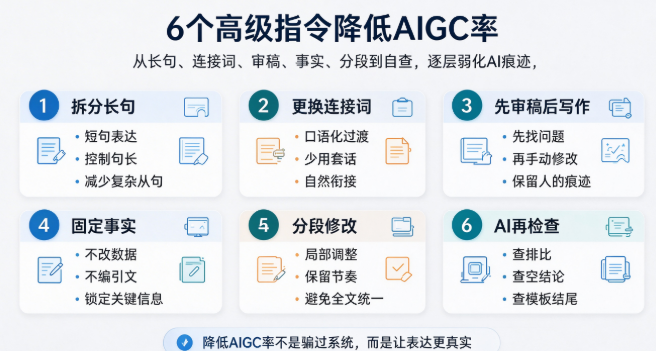
一、拆分长句,给文本做“瘦身减法”
提示词:把当前这句话拆成多个短句,单句字数控制在20字以内,原文所有信息不准增删改动。
原理:AI最擅长把好几层信息硬塞进同一个长句里,靠层层嵌套的从句刻意装出严谨高深的样子,恰恰是这类句式,属于辨识度拉满的AI典型特征,检测模型对这类结构复杂的长文本敏感度极高。把绕来绕去的复合长句拆成短小独立的短句,直接打破机器写出来的规整节奏,检测模型的识别准确率会直接大幅跳水。
举个直观例子:机器输出的原句“本研究通过实证分析得出,在一定条件下A与B之间存在负相关关系”,拆分改写后可以变成:我们做了一组实证分析,专门观察A和B的关联。在特定条件下,二者的变化趋势完全反向。简单调整完,文字的人工手写感立刻就上来了。
二、替换生硬的华丽过渡套词
提示词:把段落里过于书面化的高级连接词,全部替换成平实自然的日常表达,比如用“所以”代替“由此可知”,用“但是”替换过于生硬的冗余书面表述。
原理:“因此可以得出结论”“毫无疑问地证明了这一点”“更进一步展开研究探讨”这类烂大街的书面套话,是AI生成文本的标配素材,也是检测系统高频标记的重点特征。学术写作第一要务是把意思说准,根本不是比谁的辞藻堆砌得更花哨。换成“所以”“但是”“大体上来说”这类平实的词做过渡,看起来少了点刻意装出来的高级感,刚好能巧妙躲开检测系统的敏感识别区间。写论文是给评审导师传递观点,不是抱着书面词典来炫技的。
三、先挑文字毛病,再动手改写
提示词:请你扮演要求极度严苛的期刊审稿人,只针对当前这段文字,指出所有表达模糊、论点跳脱、模板化句式的问题,同步给出对应的修改方向和调整建议。
原理:这是一套调换操作顺序的降AIGC小妙招。要是直接把整份稿子丢给AI润色,模型会本能地补全语句、美化措辞,甚至主动乱加无关内容,反而进一步加重机器生成的印记,把AIGC检出率推得更高。但如果指令只让它排查文本缺陷,它的工作重心就会完全放在挑错上。你拿到完整的问题清单之后,自己动手完成修改,文字打磨的主动权完全攥在自己手里,文本自然会带上独属于你的真实写作痕迹,彻底避免AI二次加工带来的统一机器文风,从源头堵死模型乱添油加醋的可能。
四、锁死事实信息,严禁AI瞎编内容
提示词:当前文本调整阶段,绝对不许改动、新增、虚构作者信息、调研数据、研究结论、引文出处等所有事实类内容,你的操作权限仅限优化语言措辞。
原理:AI有个非常突出的短板:为了强行让行文读起来通顺,它会擅自乱改原文内容,甚至瞎编参考文献,闹出张冠李戴的笑话。放在学术论文里,这属于碰不得的严重硬伤。建议每开启一轮文本修改,先把这条指令抛出来约束模型,既能完成语言层面的优化,又能完全规避“为了降AIGC率反倒闹出学术不端”的致命风险。
五、分段逐段处理,拒绝一次性全文改写
提示词:只修改下面这一段内容,每一个小节都以中心句起头,规避句式重复,原文所有细节信息不许丢失。
原理:把整篇文章一次性全丢给AI处理,模型会自动开启全局统一整理模式,把全文的措辞、节奏、行文风格打磨得高度规整统一,这种“全篇毫无个人特色的顺滑感”,是辨识度极高的AI痕迹。拆成一小段一小段分开处理,就能保留你原始文稿里带着个人思考的行文节奏——独属于每个人的写作节奏,是AI最难复刻模仿的特质。
六、最后交由AI完成一轮自查校验
提示词:通读当前全文,找出文中所有排比句式、空洞无物的论断、模板化结尾,给出可落地的修改方案,让表述完全贴合实际研究内容。
原理:前面几轮手动调整完之后,再用这条指令做收尾排查。这时候AI的角色就从文稿润色工具,直接转成了排查AI痕迹的专属检查员。它比谁都熟自己生成文本的各类套路,能帮你筛掉很多人工修改时容易漏掉的模板化语句。本质就是用AI的能力,反过来对抗AIGC检测的识别逻辑。
降AIGC检出率这件事,本质上是倒逼你好好打磨论文本身。这套方法根本不是教你耍花招蒙混检测,而是把所有空洞模板化的套话,全部替换成贴合你自身研究、带着真实个人思考的表达。你完全可以从AIGC标记最严重的段落开始,逐条试用上面的指令,最后出来的文字带着质朴真实的质感,反而更能凸显研究本身的实际价值。